Wie aus einer aufgeschobenen Pflicht in drei Tagen eine kleine App wurde, die ohne Datenbank, Cloud und Abo auskommt.
Update vom 12.11.2026: Die App kann jetzt auch Firmen. Neu ist der Abschnitt «Für Firmen».
Warum überhaupt?
Seit diesem Jahr brauche ich für meine Steuererklärung (Einzelfirma) ein Fahrtenbuch. Ohne kann ich das Geschäftsauto nicht mehr steuerlich abziehen. Ich habe das so lange vor mir hergeschoben, bis auch eine Kollegin eines schreiben musste. Erst da habe ich mich wirklich drangesetzt.
Natürlich gibt es schon 2000 solcher Apps. Ich wollte aber meine eigene: auf meinem Server, ohne Zwang zur Cloud und ohne Abo. Und sie sollte das Handschreiben ablösen, nicht einfach nur ein bisschen hübscher machen.
Die Idee
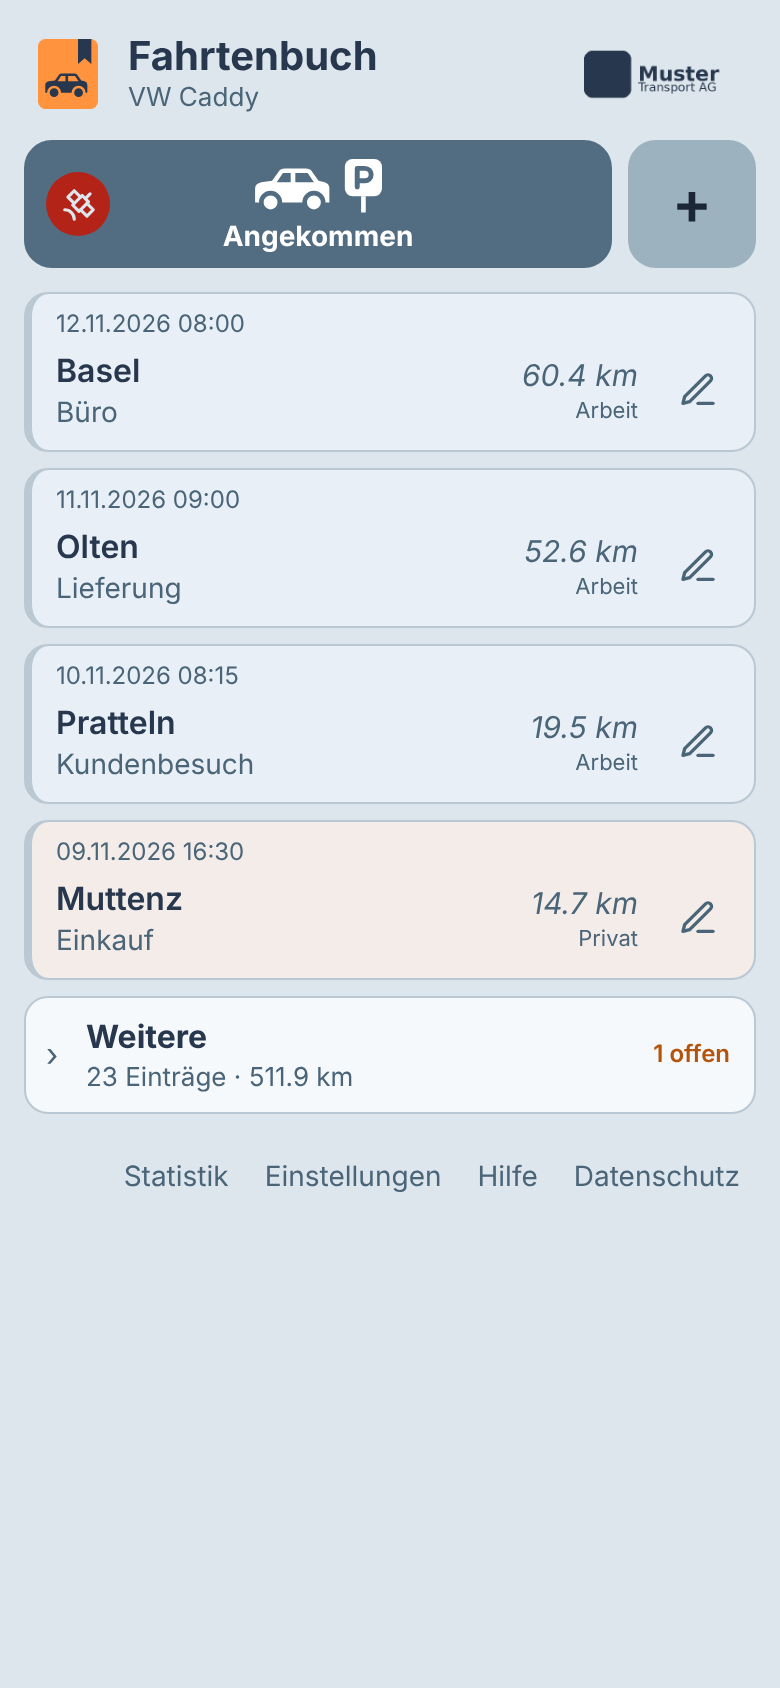
Ein Fahrtenbuch ist langweilig, solange es nicht stört. Also sollte jeder Eintrag mit einem Tipp erledigt sein: Ich stehe am Ziel, tippe auf «angekommen», das Handy kennt den Standort, den Ortsnamen ergänzt die App selbst. Wer etwas vergessen hat.
Vom Prototyp zur App
Insgesamt waren es etwa 5 Tage Entwicklungszeit: ein bis zwei Tage Prototyp, danach ein bis zwei Tage Testen und Anpassen. Unterwegs ist einiges dazugekommen, das ich am Anfang gar nicht vorhatte:
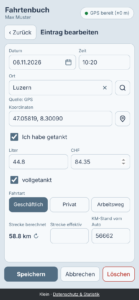
Tanken: Ich wollte Liter und Preis gleich im Eintrag festhalten.
Elektroauto: Wer lädt statt tankt, braucht kWh statt Liter. Also gibt es beides.
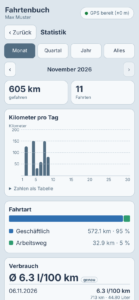
Statistik: Eigentlich ein Gimmick, aber etwas Spass muss sein! (Kilometer pro Tag, Aufteilung nach Fahrtart und der Ø-Verbrauch.)
Der KM-Stand vom Auto: Er wird mit den gefahrenen Strecken verglichen, damit einem direkt auffällt, wenn etwas nicht stimmt. Eine Abweichung gleicht die App jetzt selbst aus: als eigene, kursive Zeile «Ausgleich KM-Stand (automatisch)», die niemand von Hand ändern kann.
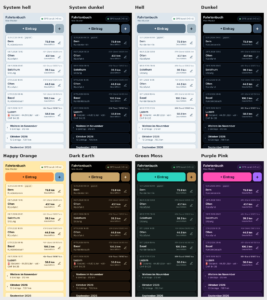
Themes: Hell, Dunkel und ein paar bunte Varianten.
Firmenübersicht: Falls sich eine Firma für meine „App“ entscheidet soll sie auch ihre Fahrzeuge gleich selbst verwalten können, mit schön Formatiertem Export für Steuerzwecke/Treuhänder und automatischer Kontrolle.
Kleine Dinge, die im Alltag viel ausmachen
Die grossen Funktionen sind schnell erklärt. Wirklich gebraucht werden aber die Kleinigkeiten:
Schnellwahl für den Zweck: Wer immer dieselben Zwecke hat, tippt sie nur noch an, statt jedes Mal zu schreiben.
Orte mit festem Zweck: Wer an einem Ort immer dasselbe macht, zum Beispiel im Büro, muss den Zweck gar nicht mehr wählen.
Schnelllink: Ein Link auf dem Homescreen und der Eintrag ist „wirklich“ mit einem Klick erledigt.
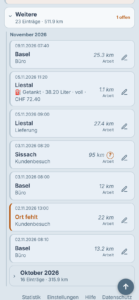
Arbeit oder Privat: Jede Fahrt lässt sich als Arbeit oder Privat kennzeichnen. Private Fahrten sind in der Liste leicht eingefärbt.
Offline-Warteschlange: Verbindung verloren? Der Eintrag wartet auf dem Handy und wird später automatisch gesendet.
Übersichtliche Liste: Die neuesten Einträge stehen oben, ältere sind unter «Weitere» pro Monat und Jahr zusammengeklappt. Fehlt bei einem Eintrag etwas, wird es markiert, damit man es nicht erst Ende Jahr entdeckt.
CSV-Export: Alle Einträge oder nur ein Monat, damit die Zahlen auch sonst wo verwendet werden können.
Fahrzeugcheck
Wer mehrere Fahrzeuge hat oder eines teilt, sitzt schnell im falschen. Auf Wunsch fragt die App beim Start deshalb «Sitzt du im Fahrzeug …?» und zeigt das Kennzeichen und Bild, falls vorhanden, gross an.
Für Firmen
Eine Firma bekommt ein eigenes Panel. Dort stehen alle Fahrzeuge und eigener QR-Code Generator. Ausgedruckt und ans Cockpit geklebt ergibt sich so eine der einfachsten Möglichkeiten die Fahrzeuglinks zu teilen. Natürlich können die Links auch als Lesezeichen oder Homescreen-Verknüpfung abgelegt werden.
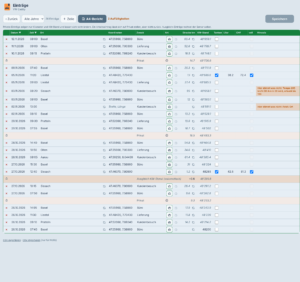
Zu jedem Fahrzeug gibt es eine Tabelle mit allen Einträgen. Sie lässt sich sortieren, Auffälligkeiten wie ein unmögliches Tempo oder ein fehlender Ort werden direkt erklärt, und Ort oder Strecke lassen sich neu berechnen.
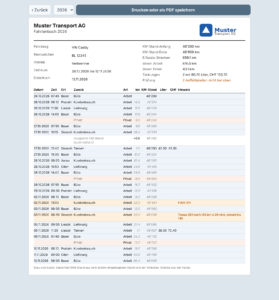
Auf Knopfdruck entsteht ein A4-Bericht mit Firmenlogo, Zusammenfassung und Prüfstatus, zum Drucken oder als PDF. Wer lieber selber rechnet, nimmt den CSV-Export.
Privates bleibt privat. Die Firma sieht von privaten Fahrten nur Kilometer und KM-Stand, ohne Datum, Ort und Zweck. Das gilt in der Tabelle, im A4-Bericht und im CSV. Arbeitseinträge darf die Firma korrigieren und ergänzen, auch rückwirkend, und per CSV importieren. Sie darf einen Eintrag von Arbeit auf Privat stellen, aber nie zurück, und sie kann selbst keine privaten Einträge anlegen. Damit niemand überrascht wird, sieht die fahrende Person bei so einem Eintrag ein oranges Fragezeichen.
Ehrlich zur KI
Ich habe das nicht allein geschrieben. Ich habe mit Claude von Anthropic gearbeitet (Sonnet 5.5, normaler Chat im Web).
So lief das ab:
Ich beschreibe, was ich will, und diskutiere es durch.
Die KI schreibt den Code, ich übernehme ihn in meine Dateien.
Ich lade alles auf den Server, führe es aus und teste es selbst, auf dem Handy und am Computer.
Ich melde zurück, was nicht stimmt. Manchmal auch mit forschem Gemecker, wenn die KI etwas «verbessert» hat, ohne dass ich es wollte.
Kleinigkeiten ändere ich lieber gleich selbst, statt eine halbe Stunde mit Erklärungsversuchen zu verbringen.
Stromdaten vom Netzbetreiber automatisch in InfluxDB und Grafana: xlsx-Import statt Zählerstände abschreiben
Kurzfassung: Ich habe jahrelang meine Stromzähler von Hand abgelesen und in InfluxDB eingetippt. Jetzt liefert die EBL die Daten als xlsx. Daraus habe ich (mit viel Hilfe von Claude) ein kleines Python-Skript gebaut, das die Datei einliest und die Serien in InfluxDB erweitert. In Grafana gibt es dazu Tagesbalken mit Total-Zahl und Kalenderwochen-Achse. Meine PV-Panels sind natürlich auch eingebunden.
Ausgangslage
Bei mir läuft openHAB, das seine Daten in eine InfluxDB 2.7 schreibt, und daneben Grafana zum Anzeigen. Meine Stromzähler (Werkstatt und Wohnung, jeweils Hoch- und Niedertarif) habe ich seit Jahren ungefähr wöchentlich von Hand abgelesen und den Zählerstand in vier Serien eingetragen. Hat funktioniert, einfach ist anders. Gerade mit den neuen Smarten Zählern, nur schon dass die mir die korrekte Zahl anzeigen ist einfach ein Graus, keine Ahnung welcher Programmierer so etwas baut und für gut befindet…
Was neu ist
Die EBL bietet jetzt an, die Messdaten direkt als xlsx herunterzuladen. Der Haken: Die Datei sieht komplett anders aus als meine bisherigen Daten.
Es sind 15-Minuten-Werte, keine wöchentlichen Zählerstände.
Es ist Verbrauch in kWh und kein Zählerstand mehr.
Hoch- und Niedertarif sind nicht mehr getrennt.
Pro Messpunkt gibt es Bezug und Rücklieferung (wichtig, wenn man eine PV-Anlage hat).
Oben stehen ein paar Kopfzeilen (Messpunkt, Typ, Einheit), danach Datum und Werte.
Zum Glück muss ich die alten Daten gar nicht umbauen. Die alten Serien lasse ich einfach stehen, und die neuen Serien beginnen dort, wo die xlsx beginnt.
Das Ziel
Backup der bestehenden Daten.
Neue Serien anlegen: zaehler_werk, zaehler_wohn und zaehler_einspeisung.
Ein Tool, das ich mit der xlsx füttere und das die Datenbank erweitert. Bereits vorhandene Daten sollen keinen Schaden anrichten.
Ehrlich gesagt: Das meiste hat Claude geschrieben
Ich mache hier keinen Hehl daraus: Claude hat mir den Code quasi hingeschissen. Ich habe die Anforderungen geliefert, die xlsx gezeigt, Rückfragen beantwortet, das Ganze getestet und gemeldet, was nicht passt. Der Code kommt von der KI, die Entscheidungen kamen von mir. Ich finde das legitim, aber ich möchte es transparent haben. Und wie bei allem, was man nicht selbst geschrieben hat: Erst prüfen, dann ausführen!
Schritt 1: Backup
Bevor ich irgendetwas ändere, habe ich alle vier alten Serien mit dem influx-CLI im Container als CSV exportiert. Ich habe bewusst nicht das InfluxDB-eigene Backup genommen, weil ich irgendwann vielleicht die Datenbank wechseln will. Eine CSV-Datei lässt sich überall wieder einlesen. Danach habe ich kurz geprüft, ob alle Serien vollständig drin sind, und die Datei sicher abgelegt.
Schritt 2: Wie sehen openHAB-Daten in InfluxDB aus?
Damit die neuen Serien genauso aufgebaut sind wie die bestehenden, habe ich mir ein paar Zeilen aus dem Backup angeschaut. Bei openHAB gilt:
Measurement = Name des Items
Field = value
Tagitem = Name des Items
Die neuen Serien schreibe ich genau so. Die Einspeisung ist die Summe der Rücklieferung aller Messpunkte.
Schritt 3: Das Skript
Das Skript heisst strom_import.py und tut Folgendes:
Es sucht im eigenen Ordner nach der xlsx. Ist genau eine da, wird sie importiert. Sonst gibt es eine Meldung.
Es liest die xlsx ohne Zusatzmodule (nur Python-Standardbibliothek). Das war eine nachträgliche Verbesserung: Die erste Version brauchte openpyxl, was ich jetzt nicht „extra noch installieren“ wollte. Eine xlsx ist im Grunde ein ZIP mit XML-Dateien, das lässt sich auch ohne Bibliothek lesen.
Es ordnet die Spalten über die Messpunkt-ID zu, nicht über die Position. Falls der Netzbetreiber mal die Spalten umsortiert, geht nichts schief.
Es rechnet die lokale Zeit in UTC um (inklusive Sommer- und Winterzeit).
Fehlende Werte (in der Datei steht dann „-“ oder die Zelle ist leer) werden übersprungen. Es werden keine Nullen erfunden.
Es schreibt die Daten per HTTP direkt in InfluxDB, in Paketen zu je 5000 Zeilen.
Warum nicht einfach CSV oder Line Protocol von Hand hochladen? Das habe ich früher versucht und bin immer wieder an Syntaxfehlern gescheitert. Wenn das Skript das Line Protocol selbst erzeugt, passieren diese Fehler nicht mehr.
Und die Frage, die mir am meisten Sorgen gemacht hat: Was passiert, wenn ich dieselbe Datei zweimal importiere? Nichts Schlimmes. In InfluxDB überschreibt ein Punkt mit gleicher Serie und gleichem Zeitstempel den vorhandenen. Es gibt also keine Duplikate, und falls der Netzbetreiber Werte nachträglich korrigiert, würden die automatisch aktualisiert.
Codeblock zum aufklappen :)
#!/usr/bin/env python3
"""
strom_import.py: Messdaten-xlsx des Stromversorgers (EBL) in InfluxDB 2.x importieren.

Die xlsx enthält 15-Minuten-Verbrauchswerte (kWh) pro Messpunkt, getrennt nach
"Bezug" und "Rücklieferung". Das Skript schreibt daraus drei Serien:

    zaehler_werk         Bezug von Messpunkt "werk"
    zaehler_wohn         Bezug von Messpunkt "wohn"
    zaehler_einspeisung  Rücklieferung (Summe aller Messpunkte)

Aufbau der Serien wie bei openHAB: Measurement = Name, Tag item = Name, Field = value.

Aufruf:
    python3 strom_import.py              die einzige xlsx im Ordner des Skripts importieren
    python3 strom_import.py datei.xlsx   eine bestimmte Datei importieren
    python3 strom_import.py --dry-run    Testlauf, es wird nichts geschrieben

Es werden keine Zusatzmodule gebraucht (nur die Python-Standardbibliothek, Python 3.9+).

Wiederholtes Einlesen ist unkritisch: Punkte mit gleicher Serie und gleichem
Zeitstempel werden in InfluxDB einfach überschrieben, es entstehen keine Duplikate.
Das Skript schreibt ausschliesslich diese drei Serien und löscht nichts.
"""
import argparse
import glob
import os
import re
import sys
import urllib.error
import urllib.parse
import urllib.request
import xml.etree.ElementTree as ET
import zipfile
from datetime import datetime, timedelta
from zoneinfo import ZoneInfo

# ---- Einstellungen: hier anpassen -------------------------------------------
INFLUX_URL = "http://localhost:8086"
INFLUX_ORG = "HIER_ORG_EINTRAGEN"          # Name deiner Organisation in InfluxDB
INFLUX_BUCKET = "openhab_db/autogen"       # Ziel-Bucket (bei openHAB-Migration oft so benannt)
INFLUX_TOKEN = "HIER_TOKEN_EINTRAGEN"      # API-Token mit Schreibrecht auf den Bucket
                                           # Achtung: Token nie öffentlich teilen!

# Zuordnung Messpunkt-ID (steht in der xlsx, Zeile "Messpunkt") zu einem Kurznamen.
# Aus "werk" wird die Serie zaehler_werk, aus "wohn" zaehler_wohn.
# Deine IDs siehst du, wenn du das Skript einmal mit --dry-run startest:
# unbekannte Messpunkte werden dann als Warnung ausgegeben.
MESSPUNKTE = {
    "CH_DEINE_MESSPUNKT_ID_1": "werk",
    "CH_DEINE_MESSPUNKT_ID_2": "wohn",
}

# Zeitstempel in der xlsx sind lokale Zeit und werden damit nach UTC umgerechnet.
ZEITZONE = ZoneInfo("Europe/Zurich")
# -----------------------------------------------------------------------------

BATCH = 5000  # Anzahl Zeilen pro Schreibvorgang
NS = "{http://schemas.openxmlformats.org/spreadsheetml/2006/main}"


def spalte(ref):
    """Zellbezeichnung wie 'D9' in einen Spaltenindex (A=0, B=1, ...) umrechnen."""
    n = 0
    for ch in re.match(r"[A-Z]+", ref).group():
        n = n * 26 + ord(ch) - 64
    return n - 1


def xlsx_zeilen(pfad):
    """Liest das erste Tabellenblatt und liefert pro Zeile ein dict {spaltenindex: wert}.

    Eine xlsx ist ein ZIP mit XML-Dateien. So lesen wir sie ohne Zusatzmodul wie openpyxl.
    Leere Zellen fehlen im dict. Texte (z.B. '-') kommen als str, Zahlen als float.
    """
    with zipfile.ZipFile(pfad) as z:
        namen = z.namelist()
        strings = []
        if "xl/sharedStrings.xml" in namen:
            for si in ET.fromstring(z.read("xl/sharedStrings.xml")).iter(NS + "si"):
                strings.append("".join(t.text or "" for t in si.iter(NS + "t")))
        blatt = sorted(n for n in namen if re.fullmatch(r"xl/worksheets/sheet\d+\.xml", n))[0]
        with z.open(blatt) as f:
            for _, row in ET.iterparse(f):
                if row.tag != NS + "row":
                    continue
                d = {}
                for c in row.iter(NS + "c"):
                    t = c.get("t")
                    v = c.find(NS + "v")
                    if t == "inlineStr":
                        val = "".join(x.text or "" for x in c.iter(NS + "t"))
                    elif v is None or v.text is None:
                        continue
                    elif t == "s":
                        val = strings[int(v.text)]
                    elif t in ("str", "e", "b"):
                        val = v.text
                    else:
                        val = float(v.text)
                    d[spalte(c.get("r"))] = val
                yield d
                row.clear()


def lies_xlsx(pfad):
    """Wertet die Kopfzeilen (Messpunkt, Typ) aus und liefert eine Liste (zeitstempel, werte).

    werte ist ein dict {(kurzname, typ): wert}, z.B. {("werk", "Bezug"): 0.019}.
    """
    messpunkt, spalten, punkte, gewarnt = None, {}, [], set()
    for r in xlsx_zeilen(pfad):
        label = r.get(2)  # Spalte C enthält die Beschriftung der Kopfzeilen
        if label == "Messpunkt":
            messpunkt = r
        elif label == "Typ":
            for i, m in (messpunkt or {}).items():
                if m in MESSPUNKTE and r.get(i) in ("Bezug", "Rücklieferung"):
                    spalten[i] = (MESSPUNKTE[m], r[i])
                elif isinstance(m, str) and m.startswith("CH") and m not in MESSPUNKTE \
                        and m not in gewarnt:
                    gewarnt.add(m)
                    print(f"WARNUNG: unbekannter Messpunkt {m}. "
                          f"Trage ihn oben unter MESSPUNKTE ein.", file=sys.stderr)
        elif isinstance(r.get(0), float) and r[0] > 30000:  # Spalte A: Excel-Datum
            if not spalten:
                sys.exit("Keine passenden Messpunkte gefunden. "
                         "Prüfe MESSPUNKTE oben im Skript (Warnungen oben beachten).")
            # Excel speichert Datum/Zeit als Tage seit 30.12.1899. Auf die Minute runden.
            lokal = datetime(1899, 12, 30) + timedelta(days=r[0])
            lokal = (lokal + timedelta(seconds=30)).replace(second=0, microsecond=0)
            ts = int(lokal.replace(tzinfo=ZEITZONE).timestamp())  # Unix-Zeit in Sekunden (UTC)
            punkte.append((ts, {k: r.get(i) for i, k in spalten.items()}))
    return punkte


def zahl(v):
    """Nur echte Zahlen gelten als Messwert. '-' oder leere Zellen sind Lücken."""
    return v if isinstance(v, float) else None


def zeilen_bauen(punkte):
    """Erzeugt InfluxDB-Line-Protocol-Zeilen und eine kleine Statistik pro Serie."""
    out, stat = [], {}
    for ts, w in punkte:
        serien = {
            "zaehler_werk": zahl(w.get(("werk", "Bezug"))),
            "zaehler_wohn": zahl(w.get(("wohn", "Bezug"))),
        }
        # Einspeisung: Summe der Rücklieferung aller Messpunkte (soweit Werte da sind)
        rueck = [zahl(v) for k, v in w.items() if k[1] == "Rücklieferung"]
        rueck = [v for v in rueck if v is not None]
        serien["zaehler_einspeisung"] = sum(rueck) if rueck else None

        for name, v in serien.items():
            s = stat.setdefault(name, {"n": 0, "fehlt": 0, "summe": 0.0, "von": ts, "bis": ts})
            if v is None:  # Lücke: nichts schreiben (keine Null erfinden!)
                s["fehlt"] += 1
                continue
            s["n"] += 1
            s["summe"] += v
            s["von"], s["bis"] = min(s["von"], ts), max(s["bis"], ts)
            # Line Protocol: measurement,tag=wert field=wert zeitstempel
            out.append(f"{name},item={name} value={round(v, 6)!r} {ts}")
    return out, stat


def schreiben(zeilen, url):
    """Schickt die Zeilen in Paketen an die InfluxDB-2-Schnittstelle /api/v2/write."""
    q = urllib.parse.urlencode({"org": INFLUX_ORG, "bucket": INFLUX_BUCKET, "precision": "s"})
    ziel = f"{url.rstrip('/')}/api/v2/write?{q}"
    for i in range(0, len(zeilen), BATCH):
        body = "\n".join(zeilen[i:i + BATCH]).encode()
        req = urllib.request.Request(ziel, data=body, method="POST", headers={
            "Authorization": f"Token {INFLUX_TOKEN}",
            "Content-Type": "text/plain; charset=utf-8"})
        try:
            urllib.request.urlopen(req, timeout=60).read()
        except urllib.error.HTTPError as e:
            sys.exit(f"Influx-Fehler {e.code}: {e.read().decode()[:500]}")
        except urllib.error.URLError as e:
            sys.exit(f"Influx nicht erreichbar: {e.reason}")
        print(f"  geschrieben: {min(i + BATCH, len(zeilen))}/{len(zeilen)}")


def datei_finden(arg):
    """Ohne Argument: genau eine xlsx im Ordner des Skripts wird verwendet."""
    if arg:
        return arg
    ordner = os.path.dirname(os.path.abspath(__file__))
    treffer = sorted(glob.glob(os.path.join(ordner, "*.xlsx")))
    treffer = [t for t in treffer if not os.path.basename(t).startswith("~$")]  # Excel-Temp-Dateien
    if len(treffer) != 1:
        sys.exit(f"Erwartet genau 1 xlsx in {ordner}, gefunden: {len(treffer)}"
                 + "".join(f"\n  {os.path.basename(t)}" for t in treffer))
    return treffer[0]


def main():
    ap = argparse.ArgumentParser()
    ap.add_argument("xlsx", nargs="?", help="Pfad zur xlsx (optional)")
    ap.add_argument("--dry-run", action="store_true", help="nur prüfen, nichts schreiben")
    ap.add_argument("--lp", help="Line-Protocol zusätzlich in diese Datei speichern")
    ap.add_argument("--url", default=INFLUX_URL, help="InfluxDB-URL")
    a = ap.parse_args()

    pfad = datei_finden(a.xlsx)
    print(f"Datei: {os.path.basename(pfad)}")
    zeilen, stat = zeilen_bauen(lies_xlsx(pfad))

    def fmt(t):
        return datetime.fromtimestamp(t, ZEITZONE).strftime("%d.%m.%Y %H:%M")

    for name, s in stat.items():
        print(f"{name}: {s['n']} Werte, {s['fehlt']} fehlend, "
              f"{s['summe']:.1f} kWh, {fmt(s['von'])} bis {fmt(s['bis'])}")

    if a.lp:
        with open(a.lp, "w") as f:
            f.write("\n".join(zeilen) + "\n")
    if a.dry_run:
        print("Testlauf, nichts geschrieben.")
        return
    if "HIER_" in INFLUX_TOKEN + INFLUX_ORG:
        sys.exit("Bitte INFLUX_ORG und INFLUX_TOKEN oben im Skript eintragen.")
    schreiben(zeilen, a.url)
    print("Fertig.")


if __name__ == "__main__":
    main()
Schritt 4: Testen und ausführen
Mit python3 strom_import.py --dry-run läuft ein Testlauf, der nur auswertet und nichts schreibt. Die Ausgabe zeigt pro Serie die Anzahl Werte, die Anzahl Lücken, die Summe in kWh und den Zeitraum. So sieht man sofort, ob die Zuordnung stimmt. Danach habe ich ohne --dry-run gestartet, und nach ein paar Sekunden stand da: Fertig.
Auffällig waren ein paar Lücken in den Daten des Netzbetreibers, zum Beispiel einige Stunden mitten in der Nacht oder ein paar Stunden, in denen einzelne Zähler keine Werte lieferten. Das Skript übergeht diese Stellen. Bei der Zeitumstellung im Herbst fehlt zudem die doppelte Stunde in der Datei. Und ganz sicher bin ich mir nicht, ob der Zeitstempel in der xlsx den Anfang oder das Ende der Viertelstunde meint. Für meine Tagesauswertungen spielt das keine Rolle, aber wer minutengenau arbeiten will kommt um eine direkte/lokale Auslesung der Zähler eh nicht rum.
Für das wöchentliche Update lade ich die neue xlsx herunter, lege sie in den Ordner, lösche die alte und starte python3 strom_import.py. Das war’s.
Schritt 5: Grafana
Jetzt wird es hübsch. Als Panel nehme ich Time series mit Draw style „Bars“.
Tagesverbrauch: Pro Serie ein Query mit sum(value) und GROUP BY time(1d). Weil die Daten 15-Minuten-Verbrauchswerte sind, ergibt die Summe pro Tag den Tagesverbrauch. Das stimmte bei mir mit den Werten des Netzbetreibers überein (hab nur genau einen Tageswert geprüft…).
Total über den Balken: Ich wollte über jedem gestapelten Balken den Gesamtverbrauch sehen, ohne dass er mitgestapelt wird (wir haben zwei Zähler im Haus, das hab ich bereits erwähnt oder?). Das geht so:
Transformation „Add field from calculation“ im Modus „Binary operation“: Werkstatt + Wohnung = Total.
Override auf das Feld Total: Stack series = Off, Show values = an, Show points = Always, Point size = 1, Line width = 0, Fill opacity = 0, und „Hide in area“ für Tooltip und Legende. Übrig bleibt nur die Zahl über dem Balken.
Kalenderwochen statt Datum: Bei Wochenansichten ist die KW-Anzeige viel angenehmer. Dafür gibt es einen Override auf das Feld Time mit der Unit time:[KW]WW. Claude hat mir dafür zuerst eine umständlichere Variante vorgeschlagen, die Unit habe dann ich selbst gefunden. Ein schönes Beispiel dafür, dass man der KI auch mal etwas beibringen kann.
PV-Anlage als Linie: Ich habe direkt an der PV-Anlage einen weiteren Zähler (Shelly PM). Der liefert einen laufend aufsummierten Zählerstand und nicht den Verbrauch pro Zeitraum. Deshalb sieht der Query so aus: last(), dann difference(), dann math(/ 60000). Der Teiler hat mich etwas Rätselraten gekostet, weil ich die Einheit aus versehen mit Wh deklariert habe, die aber eigentlich eher Wm (Wattminuten) sind, deshalb durch 60’000 für kWh. In einem Override auf diese Serie stelle ich Draw style auf „Lines“. So liegt die Produktion als Linie über den Verbrauchsbalken, und aus der Einspeisung kann ich später den Eigenverbrauch berechnen.
Fazit
Der Wechsel von handgeschriebenen Zählerständen auf die xlsx des Netzbetreibers lohnt sich: weniger Arbeit, viel genauere Daten.
Alte Daten stehen lassen und neue Serien dazu zu legen, war die entspannteste Lösung.
Wenn man ein Skript zum Schreiben in eine Datenbank hat, gehören ein Testlauf und ein Backup dazu. Auch wenn die KI sagt, es sei sicher.
Mit Grafana kann man mit etwas Fummelei erstaunlich schöne Panels bauen, auch wenn der Weg dahin über mehrere Overrides führt.
Falls du ähnliche Zähler in einer InfluxDB hast und das Skript brauchst: Du musst nur die Messpunkte-IDs und deine Token eintragen.
Ich wollte ein Spiel programmieren, das so einfach ist wie möglich. Mein erster Gedanke ging zu Curiosity von Peter Molyneux: ein Würfel, den unzählige Leute gemeinsam Schicht für Schicht freigelegt haben, jede und jeder mit einem Tipp auf ein einzelnes Feld. Dass eine so simple Handlung so viele Leute fesselt, fand ich faszinierend.
Nach einigem Hin und Her landete ich bei einer Pixelwand, bei der man einzelne Pixel antippen und zerstören kann. Das war die Idee, die ich als Prototyp umsetzen wollte.
Aus Pixeln wird TetriSwing
Als der Prototyp lief, schaute ich mir das Feld und die Quadrate an und dachte: Hmm, das sieht aus wie Tetris ohne Farbe. Damit war die Idee für ein tetrisartiges Spiel geboren, aber natürlich nicht für Tetris selbst.
Ich finde Physik cool, also stand schnell fest, dass die Teile nicht einfach fallen sollen. Du fasst ein Teil an einem Punkt an, es hängt dort wie ein Pendel, schwingt, dreht sich und will in die passende Lücke geführt werden. Das Schwingen war von Anfang an gesetzt und fest spezifiziert.
Den Namen TetriSwing habe ich selbst erfunden (Tetris plus Swing). Erst im Nachhinein habe ich gemerkt, dass er schon für andere Dinge verwendet wird. Er ist trotzdem geblieben.
Herausgekommen sind 40 Level. Die Level 1 bis 20 sind zum Einspielen, für die Rangliste zählen die Level 21 bis 40.
Programmiert hat die KI. Geprüft habe ich.
Den Code hat hauptsächlich eine KI geschrieben (in diesem Fall Claude von Anthropic). Trotzdem würde ich es nicht Vibe-Coding nennen, denn ich habe jede Funktion zig Mal selbst geprüft. Gearbeitet habe ich ohne Agenten und ohne Token-Verbrauch, nur über die Weboberfläche: Code kopieren, lokal ausführen, testen, Rückmeldung geben, wieder von vorn.
Das war nicht immer lustig. Manche Details musste ich der KI zig Mal «beibringen», bis sie wirklich richtig umgesetzt waren. Dass Claude auch teilweise sehr vergesslich ist oder Sachen einfach nicht so umsetzt oder macht wie Mensch das will ist ja auch bekannt ;). Mit der Zeit lief es aber immer reibungsloser, je vollständiger das Projekt wurde. Die KI kannte das Spiel dann besser, und ich wusste besser, wie ich etwas beschreiben muss.
Testing: mein Finger ist im Weg
Getestet habe ich allein, am PC mit Edge und Firefox, mobil mit iOS Safari und Android Chrome. Am PC lief alles bald ganz gut. Auf dem Handy kam die Ernüchterung: Man sieht das Teil nicht mehr, weil der Finger draufliegt. Am PC ist mir das nie aufgefallen, denn ich patsche ja nicht mit der Hand auf den Bildschirm, ich habe eine Maus. :D
Das Testing hat vor allem die Bedienung auf Mobile komplett umgekrempelt:
Layout: Das Spielfeld liegt oben, die Teile unten in einer Ablage, getrennt nur durch eine Linie. Rahmen sind weg, der Hintergrund ist dekorativ und geht scheinbar endlos weiter, damit das Feld so gross wie möglich wird. Vorher war das alles anders.
Zellengrösse: Sie richtet sich nach dem Bereich, in dem die Lücken tatsächlich liegen, damit nichts Platz verschwendet.
Stange: Auf Touchscreens hängt das Teil nicht mehr direkt am Finger, sondern an einer Stange. Der Finger bleibt unten, das Teil ist sichtbar. Wer will, stellt im Menü «Bedienung» auf Auto, mit Stange oder direkt.
Griffpunkt: Ein Punkt mit pulsierendem Ring zeigt, wo das Teil festgehalten wird.
Hinweis-Knopf: Ab Level 15 gibt es einen Hinweis. In den Leveln davor leuchtet die Lücke einfach.
Hilfe-Animationen: Sie sind schneller geworden, der Rest des Bildes wird abgedunkelt, damit man sieht, was passiert.
Kleinigkeiten: Die Lupe von iOS beim längeren Drücken ist unterdrückt, und im Level-Menü steht beim neuesten Level «Weiterspielen».
Beim Feintuning war die Pendelphysik selbst ein Dauerbrenner. Auf dem Handy mit kleinen Zellen reagieren die Teile viel nervöser auf Fingerbewegungen als am PC, und das Teil fängt zu schnell an zu drehen. Das könnte eine ewige Baustelle sein. Und darf ich erwähnen dass es von Handy zu Handy Unterschiede in der Geschwindigkeit gibt und deshalb auch im Verhalten der Drehbewegung? Gut… lassen wir das.
Livegang und erste Zahlen
Am 05.11.2026 habe ich den Link in zwei Chatgruppen geteilt. Mehr „Werbung“ gab es nicht, also sind es bisher nur Freunde und Bekannte. Insgesamt haben vielleicht 20 Leute gespielt, mindestens 8 davon haben das Spiel durchgespielt und stehen (ohne Doppelungen) in der Rangliste. Im Schnitt braucht man laut Rangliste rund 20 Minuten.
Zusätzlich habe ich mit Matomo mitgezählt, wie oft welches Level gestartet wurde. Die Zahlen sind etwas kleiner als die echten, weil nicht alle Besucher getrackt werden, aber das Muster ist interessant:
Level 1 haben 17 Besucher gestartet, Level 40 noch 10. Die Kurve fällt sehr flach ab. Wer einmal drin ist, spielt meistens bis zum Schluss.
Den Hinweis-Knopf (ab Level 15) haben Besucher in diesem Zeitraum rund 275 Mal gedrückt, mit grossem Abstand am meisten in den letzten Leveln: Bei Level 38 und Level 40 haben 9 von 10 Besuchern den Hinweis benutzt.
Die härtesten Level sind also die letzten, und genau da wird der Hinweis zum Retter in der Not.
Die schnellste Zeit in der Rangliste liegt bei 6:41.8, die zweitschnellste bei 10:59.4. Meine eigene Bestzeit nach zig Testläufen: etwa 9 Minuten. Ich wurde also deutlich geschlagen.
Mein Anti-Cheat hatte einen Rechenfehler
Damit niemand die Rangliste mit Fantasiezeiten füllt, habe ich eine Anti-Cheat-Prüfung eingebaut: Die Rangliste lehnt jede Zeit unter 7 Minuten ab. Meine Bestzeit war ja 9 Minuten, also schien mir das sicher, dass niemand „noch viel schneller“ sein kann…
Dann kam jemand mit 6:41.8. Zum Glück war meine Prüfung falsch berechnet: Ich hatte 6 statt 7 Minuten eingetragen (360 statt 420 Sekunden). Sieben mal sechzig zu rechnen ist offenbar doch schwer. Sarkasmus off. Ohne diesen Fehler wäre eine ehrliche Bestzeit abgelehnt worden. Ich habe die Grenze inzwischen korrigiert.
Ausserdem ist nichts Verdächtiges passiert. Bei einer kleinen Gruppe mit wenig IT-Wissen gab es keine echten Betrugsversuche. Was nach «Cheaten» aussah, war ein Feature, das ich absichtlich eingebaut habe: Man kann einzelne Level wiederholen, um seine Zeiten zu verbessern, statt das ganze Spiel nochmals durchzuspielen. Eine Person hat das auf die Spitze getrieben: Sie drückte so lange auf den Hinweis, bis sie die Lösung auswendig kannte, startete neu und spielte das Level dann in kürzester Zeit durch. ;)
Niemand liest Texte
Das hatte ich erwartet, trotzdem hat es mich erstaunt: Keine Sau liest Texte. Nicht mal die kürzesten werden gelesen, sie werden einfach weggeklickt. Und ehrlich gesagt: Was soll man bei einem so einfachen Spiel auch gross erklären?
Die Folgen:
Nur wenige wussten, dass man Level wiederholen kann.
Bis heute weiss niemand, dass man von Anfang an direkt auf Level 21 springen kann.
Das Easter Egg wurde erst gefunden, nachdem ich verraten hatte, dass es eines gibt. :D
Daraus ziehe ich für die Zukunft zwei Schlüsse. Erstens baue ich noch weniger Text ein. Zweitens werde ich Dinge, die man wissen sollte, mit kurzen, «forcierten» Hilfsanimationen zeigen. Etwas zu sehen bringt die Leute eher dazu, etwas zu lernen, als etwas zu lesen.
Was ich mitnehme
Wer nur am PC testet, baut ein Spiel für Mausbesitzer. Wer auch für Mobile entwickeln will: Echte Geräte mit echten Fingern sind unersetzlich.
Prüfregeln gegen Betrug nachrechnen!
Spieler lesen nicht, sie probieren. Was wichtig ist, muss sich zeigen, nicht erklären.
KI schreibt den Code, aber ohne jemanden, der alles ausprobiert und präzise rückmeldet, wird daraus kein gutes Spiel.
Und jetzt bist du dran: Spiel es, schlag die 6:41.8 und sag mir, ob du das Easter Egg findest.
Aufbau: Das Spiel besteht aus spiel.php (HTML, CSS und JavaScript in einer einzigen Datei) und bestenliste.php (Server-Teil). Gerendert wird mit Canvas, Geräusche kommen über die Web Audio API aus dem Ordner audio/.
Eingabe: Pointer Events (pointerdown, pointermove, pointerup) und touch-action: none. Das Layout nutzt 100dvh, damit die Browserleiste auf dem Handy nicht stört.
Physik: Das Teil hängt an einem Greifpunkt wie ein Pendel. Pro Frame wird ein Drehmoment aus Schwerkraft und Trägheitskraft des geglätteten Fingers berechnet, dazu kommt eine Dämpfung der Drehung. In der Nähe einer Lücke wirkt ein Sog auf Lage und Winkel, bis das Teil einrastet. Alle Parameter (G, DAMP, PIV, SOG_K, SOG_D und weitere) stehen als Variablen in einem TUNE-Block.
Stange (Touch): Der Greifpunkt liegt um rund 4.5 Zellen (mindestens 90 px) über dem Finger und gleitet beim Anfassen weich nach oben.
Layout: Die Zellengrösse ergibt sich aus dem Begrenzungsrechteck der Lücken plus einer Zelle Rand. Hochkant-Geräte drehen das Level um 90 Grad (mit Hysterese gegen Flackern). Der dekorative Hintergrund wird einmalig in ein Offscreen-Canvas gezeichnet.
Rangliste: bestenliste.php gibt ein signiertes Einmal-Token (HMAC) aus. Gespeichert werden die besten 1000 Einträge. Die Anzeige zeigt die Top 10 oder ein Fenster um den eigenen Platz (4 davor, 5 danach) mit < und > zum Blättern.
Statistik: Matomo-Ereignisse nur für «Start» und «Hinweis». Gezählt werden nur neu begonnene Level, Wiederholungen werden gefiltert.
Test: Headless Chrome mit Playwright und simulierten Touch-Ereignissen über das Chrome DevTools Protocol, dazu ein lokaler PHP-Server für die Rangliste (<- das hat Claude selbst gemacht).
Das Spiel selbst habe ich dann unter „echten Bedingungen“ jeweils selbst geprüft.
Sendet bei Änderung die neue externe IP-Adresse per E-Mail.
Wie tut er es?
Ein Bash-Skript läuft alle 15 Minuten per Cronjob in einem Alpine-LXC-Container. Es prüft die externe IP über ifconfig.me, speichert sie in eine .txt Datei und vergleicht sie mit der letzten. Bei Änderung erfolgt der Versand per sendmail / ssmtp.
ssmtp
per „apk add ssmtp“ installieren config file anpassen unter „/etc/ssmtp/ssmtp.conf“
root: E-Mail-Adresse, an die System-Mails (z.B. von root) weitergeleitet werden
mailhub: SMTP-Server-Adresse mit Port (465 = SMTPS, verschlüsselt)
AuthUser: Benutzername für die SMTP-Authentifizierung
AuthPass: Passwort für die SMTP-Authentifizierung
UseTLS: Aktiviert TLS/SSL-Verschlüsselung
FromLineOverride: Erlaubt das Überschreiben der Absenderadresse beim Senden
Script
#!/bin/bash

# Pfad zur Datei, in der die letzte IP-Adresse gespeichert wird
IP_FILE="/home/ipchange/last_ip.txt"
# E-Mail-Empfänger
EMAIL_RECIPIENT="asdf@asdf.ch"
# Absender-E-Mail
EMAIL_SENDER="asdf@asdf.ch"

# Aktuelle externe IP-Adresse abfragen
CURRENT_IP=$(curl -s ifconfig.me)

# Prüfen, ob die Datei mit der letzten IP existiert
if [ -f "$IP_FILE" ]; then
    LAST_IP=$(cat "$IP_FILE")
else
    LAST_IP=""
fi

# Vergleich der IP-Adressen
if [ "$CURRENT_IP" != "$LAST_IP" ]; then
    echo "IP-Adresse hat sich geändert:"
    echo "Alte IP: $LAST_IP"
    echo "Neue IP: $CURRENT_IP"

    # E-Mail-Inhalt erstellen (mit Headern)
    (
        echo "To: $EMAIL_RECIPIENT"
        echo "From: $EMAIL_SENDER"
        echo "Subject: Externe IP-Adresse hat sich geändert"
        echo ""
        echo "Die externe IP-Adresse hat sich geändert."
        echo ""
        echo "Alte IP: $LAST_IP"
        echo "Neue IP: $CURRENT_IP"
    ) | sendmail "$EMAIL_RECIPIENT"

    # Neue IP-Adresse speichern
    echo "$CURRENT_IP" > "$IP_FILE"
else
    echo "IP-Adresse unverändert: $CURRENT_IP"
fi